2장. 모스, 점과 선으로 쪼개다
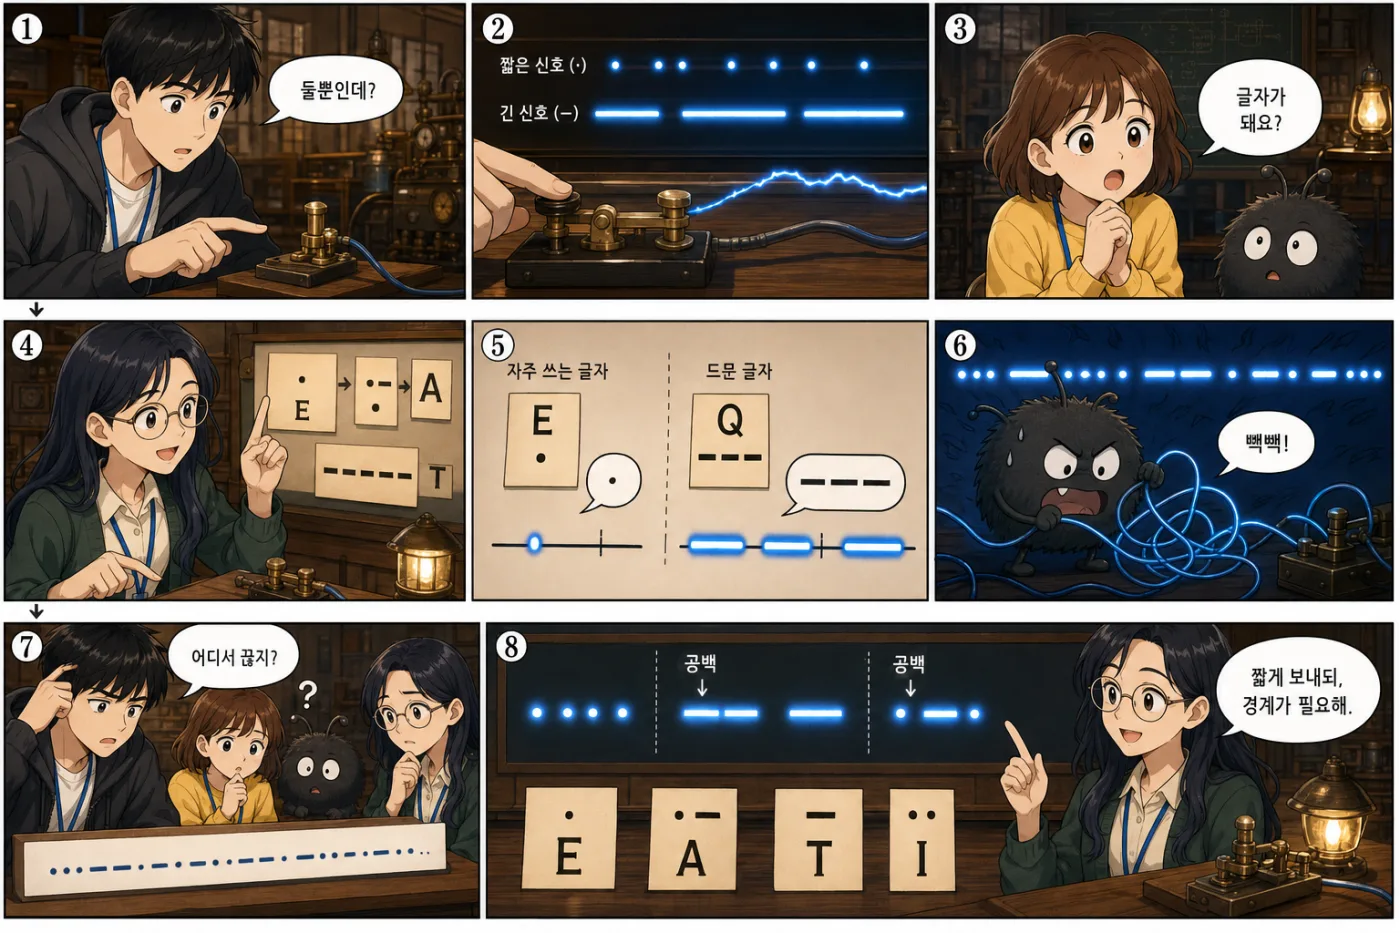
만화로 보는 요약 — 먼저 읽어보세요
모스는 점과 선의 가변 길이로 자주 쓰는 글자를 짧게 보내지만, 기계가 글자를 구분하려면 반드시 간격이라는 경계가 필요하다.
면접 실전 질문: ① 모스 부호가 빈도를 반영한 방식은? ② 가변 길이 부호의 장점은? ③ 왜 글자 사이 간격이 필요한가?
배경 — 켜짐과 꺼짐, 딱 두 가지
19세기, 전선이 도시를 잇기 시작합니다. 전선으로 할 수 있는 건 딱 하나였어요. 전류를 흘리거나(켜짐), 끊거나(꺼짐). 그게 전부입니다. 색도 없고, 모양도 없고, 각도도 없어요.
1장의 봉화는 그래도 “개수”라는 여유가 있었죠. 그런데 전선엔 켜짐/꺼짐 두 가지밖에 없습니다. 이 빈약한 두 상태로, 알파벳 26자와 숫자와 문장부호를 전부 실어 날라야 해요. 어떻게 하면 될까요?
스토리 — 짧은 신호, 긴 신호
새뮤얼 모스와 동료 앨프리드 베일의 답은 우아했습니다. 켜짐의 길이를 두
가지로 나누자. 짧게 켰다 끄면 점(·), 길게 켰다 끄면 선(—). 이 점과 선을
조합해 글자마다 고유한 패턴을 배정한 거예요. A는 ·—, B는 —···, S는 ···,
O는 ———. 조난 신호 SOS가 ··· ——— ···인 이유죠. (여기 적은 부호는
오늘날 쓰는 국제 표준(International Morse)이고, 모스·베일의 원안을 뒤에 다듬은
것입니다. SOS 조난 신호도 20세기 초 국제 규약에서 정해졌고요.)
여기서 진짜 영리한 부분이 나옵니다. 모든 글자를 같은 길이로 만들지 않았어요. 자주
쓰는 글자는 짧게, 드문 글자는 길게 배정했습니다. 영어에서 제일 많이 나오는 E는 점
하나(·), T는 선 하나(—)로 제일 짧아요. 반대로 잘 안 쓰는 Q는 ——·—로 길죠.
전해지는 이야기로는, 베일이 이 빈도를 알아내려고 인쇄소의 활자 통을 뒤졌다고 합니다.
많이 닳은 활자 칸이 곧 자주 쓰는 글자였으니까요.
왜 이렇게 했을까요? 자주 쓰는 걸 짧게 하면 전체적으로 더 빨리 보낼 수 있으니까요. 1초라도 아끼려는, 아주 실용적인 최적화였습니다.
핵심 — 두 기호, 가변 길이, 그리고 한계
모스 부호를 인코딩의 눈으로 보면 두 가지 강점과 결정적 약점 하나가 보입니다.
- 딱 두 기호로 모든 글자 — 점과 선, 본질적으로 켜짐/꺼짐. 이게 훗날 컴퓨터의
0과1로 이어지는 이진(binary)의 먼 조상입니다. 세상 모든 글자를 단 두 개의 기호 조합으로 표현할 수 있다는 발상이 여기서 실증됐어요. (점·선은 뜻을 나르는 데이터 기호고, 사이의 간격은 그 경계를 나누는 구분자입니다. 역할이 다르죠.) - 가변 길이 + 빈도 최적화 — 글자마다 신호 길이가 다르고, 자주 쓰는 걸 짧게 한다. “많이 나오는 걸 짧게 부호화한다”는 이 아이디어는 뒷날 데이터 압축과 UTF-8의 가변 길이(자주 쓰는 ASCII는 1바이트, 드문 글자는 여러 바이트)로 이어지는 사상의 씨앗이에요.
코드로 흉내 내 볼까요.
MORSE = {"S": "...", "O": "---", "E": ".", "T": "-"}
def encode(text): return " ".join(MORSE[c] for c in text)

print(encode("SOS"))   # ... --- ...
그런데 여기서 모스의 결정적 한계가 드러납니다. 위 코드에서 저는 글자 사이에 공백을
넣었어요(" ".join). 왜냐면 안 그러면 ...---...이 붙어버려서, 이게 SOS인지
EEETTTEEE(. . . — — — . . .)인지 구분할 수가 없거든요.
가변 길이의 저주입니다. 글자마다 길이가 다르니, 어디서 한 글자가 끝나고 다음이 시작되는지 알 수가 없어요. 그래서 모스는 반드시 글자 사이에 간격을, 단어 사이에 더 긴 간격을 둬야 합니다. 사람이 귀로 듣고 손으로 칠 땐 이 간격을 리듬으로 자연스럽게 처리하지만, 기계는 이 모호함을 싫어합니다. “정확히 몇 칸이 글자 경계인가?”를 기계가 매번 판단하긴 번거롭거든요.
즉 모스는 사람에게 최적화된 인코딩이었어요. 점과 선, 빈도 최적화까지 갔지만, 기계가 자동으로 척척 처리하기엔 경계가 흐릿했습니다. 전신 기사의 숙련된 귀와 손에 기대는 방식이었죠.
정리
- 전선은 켜짐/꺼짐 두 상태뿐. 모스는 켜짐의 길이(점·선)로 이 둘을 늘려 글자를 실었다.
- 인코딩 관점 3가지는 ① 두 기호로 모든 글자(이진의 조상) ② 가변 길이 + 빈도 최적화
(자주 쓰는
E·T를 짧게 → 데이터 압축·UTF-8 가변 길이의 사상적 조상) ③ 가변 길이라 글자 경계가 모호해 간격(구분자)이 필요하다. - 그래서 모스는 사람에게 최적화됐지만, 기계 자동 처리엔 불편했다.
생각해볼 질문: 경계가 흐릿한 게 문제라면, 아예 모든 글자를 똑같은 길이로 만들면 어떨까요? “이 신호는 무조건 5칸짜리”라고 못 박으면, 기계는 5칸씩 뚝뚝 끊어 읽기만 하면 되잖아요. 빈도 최적화라는 영리함을 포기하는 대신 기계가 편한 길, 고정 길이 부호의 시대로 갑니다.