Blog
위키가 쌓이면, 글이 됩니다
Calix Wiki에 축적된 지식을 AI가 한 편의 글로 정리합니다.
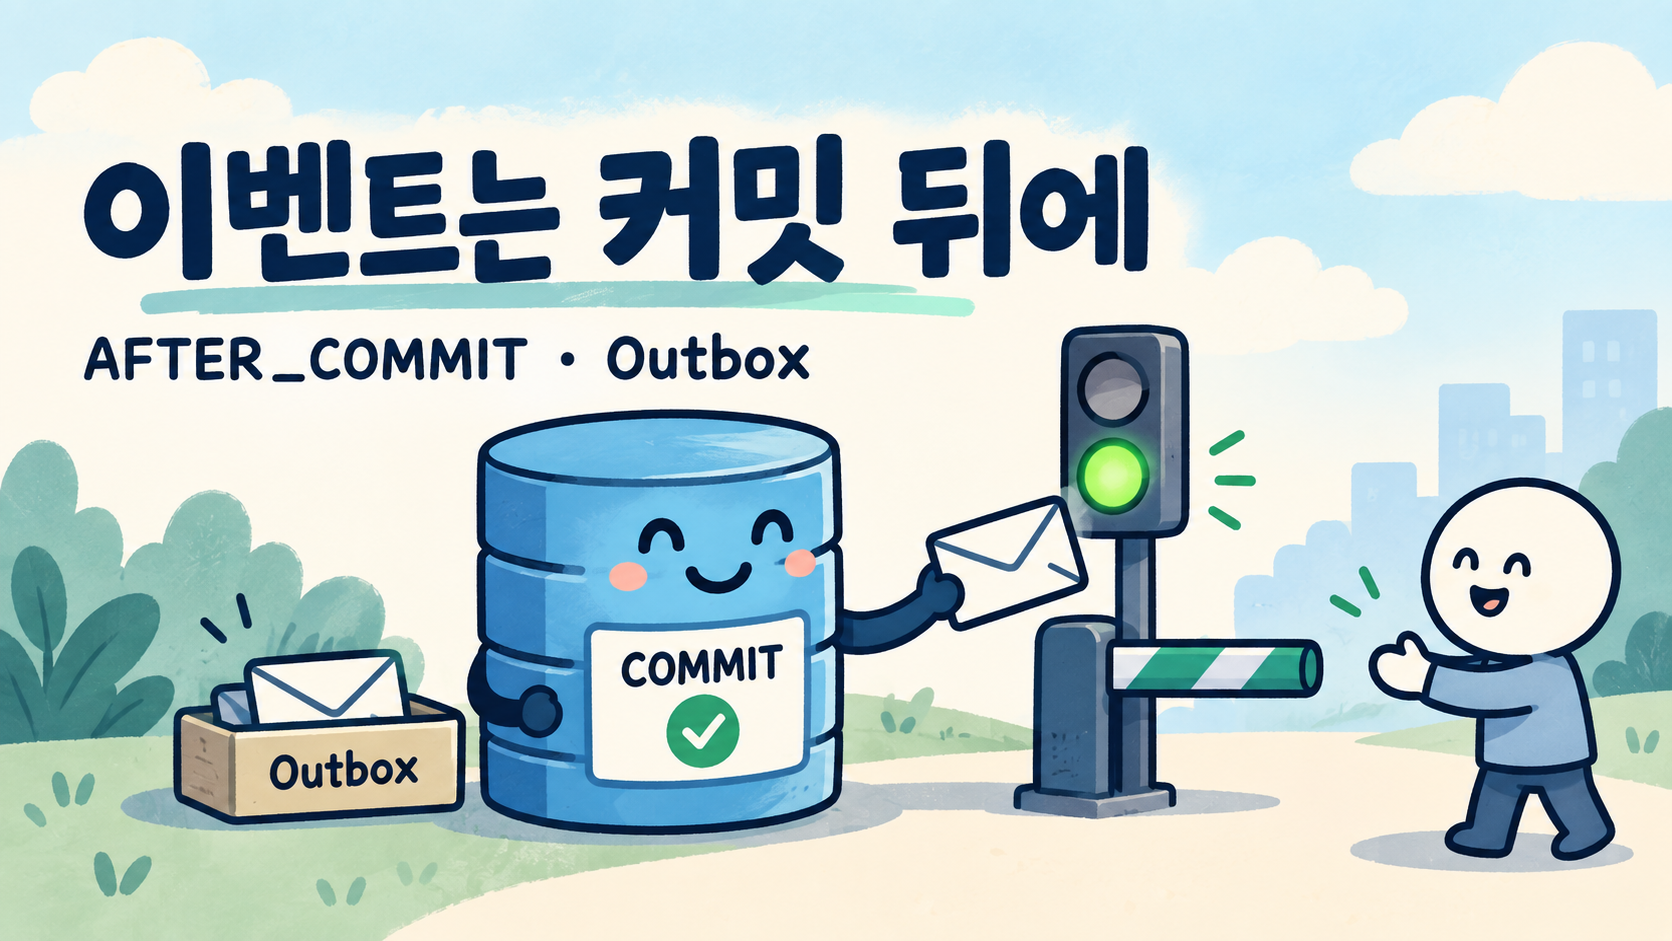
DB에는 있는데 Consumer는 못 찾았다 — 이벤트가 커밋을 앞선 순간
Kafka Consumer가 데이터를 조회하지 못했는데 나중에 DB를 열어보니 행이 있었다. 외부 전송을 커밋 뒤로 옮기는 과정에서 만난 공유 리스너와 후처리 저장 문제, AFTER_COMMIT과 Outbox의 서로 다른 보장을 정리했다.
AI가 읽는 시대에, 사람이 읽기 좋은 프로젝트 문서 만들기
3년차 개발자가 팀 온보딩과 인수인계를 위해 프로젝트 통합 문서를 만들고 있습니다. 읽는 순서, 의사결정의 맥락, 지식 전달과 유지 비용까지 고려하며 협업의 기반을 정리하는 기록입니다.
빌드에 규칙을 뒀는데, 빌드가 안 보는 곳이 있었습니다
지난 글에서 "문서는 잊히지만 빌드는 잊히지 않는다"로 끝냈습니다. 실제로 코드를 옮겨보니 절반만 맞았습니다. 아키텍처 테스트는 스캔 범위 밖으로 나간 코드를 조용히 놓쳤고, 초록불인 줄 알았던 빌드는 실제로 테스트를 돌리지 않은 상태였습니다. 반대로 새로 세운 규칙은 이관 전부터 있던 결함을 즉시 잡아냈습니다. 빌드는 자기가 보는 범위 안에서만 잊지 않았고, "하면 안 되는 것"은 잘 잡지만 "해야 하는 것"은 거의 못 잡았습니다.
전략 패턴으로 옮길수록 배치에서 취소가 깨졌습니다
배치의 망취소에서 특정 결제사 취소가 로그 한 줄만 남기고 조용히 실패했습니다. 파고들었더니 구현체가 배치 모듈의 클래스패스에 아예 없었고, 그건 아키텍처 가이드가 정해둔 경계였습니다. "의존성 한 줄 추가"를 권했다가 규칙 위반임을 알고 되물렀고, 계획을 검증하다 환불 패키지 안에 승인 쪽 코드가 섞여 있는 것까지 발견했습니다. 결론은 모듈을 기능이 아니라 소비자 집합으로 가르는 것이었습니다.
"까먹지 말자"로는 세 번째도 까먹습니다
자체 모바일 POS는 거래 상태를 Redis에서 읽습니다. 그 캐시를 갱신하는 일이 결제 흐름마다 각자 챙기는 구조였고, 두 번 잊었습니다. 화면이 안 바뀌는 정도가 아니라 단말이 기다리다 취소를 걸어 정상 승인된 결제가 취소됐습니다. 세 번째 이벤트를 추가하는 대신 전이와 발행을 분리할 수 없게 묶고, 우회를 빌드 실패로 막았습니다. 그 과정에서 제가 쓴 가드가 실제 위반을 조용히 통과시키고 있었다는 것, 새로 세운 원칙을 세 곳 중 한 곳에만 적용했다는 것, "5초 지연"이라 계산했던 비용이 실은 "결제 취소"였다는 것을 차례로 발견했습니다.
리뷰가 잡은 것은 전부 계획이었습니다: 구현 실수는 한 건도 없었습니다
앞 편에서 만든 공통 전이 장치를 실제로 9곳에 적용했습니다. 태스크마다 독립 리뷰를 붙였는데, 아홉 번의 리뷰가 잡아낸 것 중 구현자의 실수는 한 건도 없었습니다. 전부 계획 쪽 결함이었습니다. 커밋을 롤백 블록 안에 두라고 지시해 장애 원인이 사라지게 만든 것, 조건 밖에 있던 문장을 조건 안으로 옮겨 실패한 결제를 진행중으로 방치하게 만든 것, 감시할 수 없는 메서드를 감시 목록에 넣어 화이트리스트가 영원히 비지 않게 만든 것. 그리고 마지막 전체 리뷰가 찾은 것은 제가 만든 검증 게이트 자체의 결함이었습니다. 그 게이트는 "값이 새로 생기는가"를 물었고, "틀린 값이 생기는가"는 묻지 않았습니다.
100만 건을 엑셀로 내려받다: 느렸던 건 쿼리가 아니라 자료구조였습니다
거래내역 한 달치(약 100만 건)를 엑셀로 받으려다 타임아웃이 났습니다. 처음에는 쿼리가 느린 줄 알았고 실제로 느렸지만, 쿼리를 고쳐도 100만 건은 통과하지 못합니다. 같은 데이터가 JSON 문자열 → 객체 그래프 → JS 객체 → 셀 객체로 네 번 펼쳐지고 있었고, 각 단계가 건수에 비례해 메모리를 먹었기 때문입니다. 행 지향 Map을 열 지향 배열로 바꾸는 것만으로 payload가 절반이 되는 이유와, SXSSF의 슬라이딩 윈도우가 무엇을 포기하고 무엇을 얻는지를 정리합니다. 엑셀 시트의 1,048,576행 한계가 왜 2의 20제곱인지도 함께 적었습니다.
리뷰가 컴파일러였습니다: 빌드를 못 돌리는 환경에서 구현한 기록
앞 편에서 설계까지 갔던 서버 측 엑셀 생성을 실제로 구현했습니다. 이 환경은 망 분리라 gradle도 npm도 돌지 않습니다. 테스트 23개를 썼고 0개를 실행했습니다. 그 상태에서 리뷰가 잡아낸 것은 스타일이 아니라 컴파일 오류였고, 정산 증빙에 같은 거래를 두 번 찍는 버그였습니다. 규모가 한 자릿수 바뀌자 없던 제약이 생겼고, 메모리를 아끼려 넣은 청크 분할이 새 버그를 만들었습니다. 제가 반복해서 틀리게 말한 것들도 함께 정리합니다.
장애가 심해질수록 알람이 조용해졌습니다
결제 승인이 무더기로 실패하는 동안 모니터링 배치는 "정상"을 찍고 있었습니다. 범인은 집계 쿼리의 INNER JOIN이었습니다. 응답을 못 받은 실패 건은 결과 테이블에 행이 생기지 않아 조인에서 탈락했고, 그래서 장애가 심할수록 세어지는 건수가 줄어 더 정상처럼 보였습니다. 시간대를 먼저 의심했지만 그건 아니었고, 대신 엉뚱한 곳에서 진짜 시간대 버그가 나왔습니다. 판정 기준을 "거래가 있었는가"에서 "승인이 났는가"로 바꾸고 지표를 넷으로 쪼갠 과정, 뒤늦게 드러난 설계 결함 셋, 아직 DB에 붙여 돌려보지 못한 채로 남은 것들의 기록입니다.
"확인했습니다"라고 쓴 것 중 셋이 틀렸습니다
모니터링이 "정상"이라고 했는데 장애였습니다. 그걸 고치는 설계서를 썼는데, 검토에서 제가 "확인했다"고 단정한 사실 셋이 틀렸다는 게 드러났습니다. 구현을 마치고 마지막 리뷰에서 또 나왔습니다. 발송 로그가 "성공 2건"이라 말하는데 실제로 전달됐는지는 알 수 없는 구조였고, 안전장치로 만든 클래스는 아무도 쓰지 않고 있었습니다. 고치려던 병에 세 번 걸린 기록이고, 무엇이 그걸 잡아냈는지에 대한 기록입니다.
느린 로그 조회, 운영 데이터로 원인을 좁혀보기
로그 테이블 네 개의 크기, 실제 DDL, 인덱스와 여덟 실행계획을 대조했습니다. 확인한 사실과 아직 측정하지 않은 부분을 나누고, 조회 조건별 인덱스 후보를 정리합니다. 거래 로그 개선기 1편, 운영 조사와 인덱스 검토.
로그 저장 구조를 바꾸고 인덱스를 적용하기까지
로그 저장과 실시간 처리를 배치 애플리케이션에서 분리하는 방향을 잡았습니다. Kafka 소비 중단부터 인덱스 적용, 누적 로그 회복까지 검증할 항목을 정리합니다. 거래 로그 개선기 2편이며 운영 결과는 적용 후 보완합니다.