16장. 커버링 인덱스 — 왕복을 없애는 값
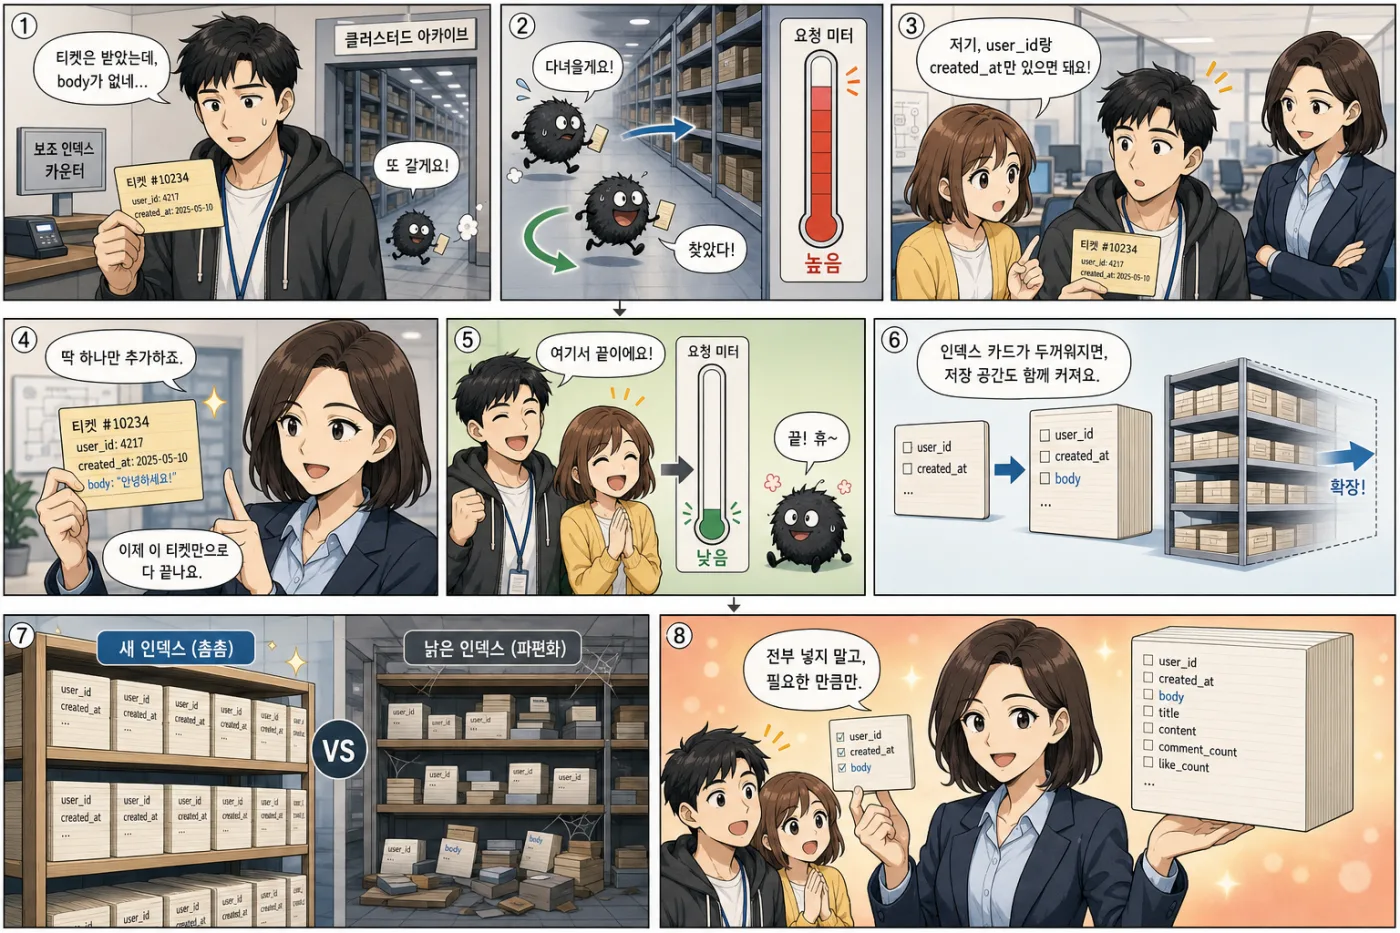
만화로 보는 요약 — 먼저 읽어보세요
세컨더리에서 PK만 받으면 행마다 왕복 → 필요한 컬럼을 인덱스에 담아 제거 → 읽기는 크게 줄고 인덱스 폭은 커짐 → 쿼리별로 필요한 만큼만 설계.
면접 실전 질문: ① 커버링 인덱스가 뭔가요? ②
Using index와Using index condition은 뭐가 다른가요? ③ 인덱스에 컬럼을 다 넣으면 되지 않나요?
인덱스에 컬럼 하나를 더 붙였더니 같은 조회의 페이지 요청이 49,524회에서 216회로 떨어졌습니다. 229배예요. 12장에서 옵티마이저가 13.1%에 인덱스를 버리게 만들던 그 왕복이 통째로 사라집니다. 대신 인덱스가 3.8배로 부풉니다.
배경 — 4부가 값을 치른 이유
4부는 여기까지 쓰기가 무는 값이었습니다. 키 모양이 정하는 계수(13장), 분할이 남기는 빈 공간(14장), 그걸 받아내는 완충(15장)이요.
그런데 이 값을 왜 치르고 있었을까요. 읽기 때문입니다.
왕복이 없으면 어떻게 되냐고 12장 질문 1이 물었고, 15장이 그 질문을 여기로 넘겼습니다.
재봤습니다. 페이지 요청이 229분의 1이 됩니다.
그리고 13장에서 잘라낸 축이 하나 있습니다. 거기서는 키의 모양만 재려고 폭을 20바이트로 통제했죠. 커버링 인덱스는 폭을 사서 왕복을 파는 거래라, 그 잘라낸 축이 여기서 값을 청구합니다.
스토리 — 답이 인덱스 안에 있으면
세컨더리 인덱스 리프에는 두 가지가 들어 있습니다. 인덱스 컬럼의 값과 PK요(7장).
SELECT COUNT(body) FROM rt_random WHERE txno BETWEEN ? AND ?;idx_txno로 이 쿼리를 풀면 이렇게 됩니다. 인덱스에서 조건에 맞는 txno를 찾아요. 거기 body는 없으니, 같이 저장된 PK를 들고 클러스터드 인덱스로 내려가 행을 읽습니다. 찾은 행마다 한 번씩요.
그런데 인덱스가 (txno, body)라면 어떨까요.
내려갈 이유가 없습니다. 조건도 txno로 걸고 답도 body인데 둘 다 인덱스 안에 있으니까요. 인덱스만 읽고 끝납니다.
이게 커버링 인덱스입니다. 별도의 인덱스 종류가 아니라 “이 쿼리에 필요한 컬럼이 다 들어 있는 상태”를 부르는 말이에요. 같은 인덱스가 어떤 쿼리에는 커버링이고 어떤 쿼리에는 아닙니다.
EXPLAIN의 Extra가 알려줍니다.
9장에서 정리한 표가 그대로 적용됩니다.
Extra | 뜻 | 왕복 |
|---|---|---|
Using index | 커버링. 인덱스 안에서 답이 나옴 | 안 감 |
Using index condition | 조건 일부를 엔진에 내려보냄(ICP) | 감 |
Using where | 서버가 마지막에 한 번 더 걸러냄 | 감 |
왕복 여부를 읽는 건 Using index가 있느냐 없느냐입니다. Using index condition은 왕복 표시가 아니라 ICP(인덱스 컨디션 푸시다운)라는 별개의 최적화가 걸렸다는 뜻이에요. 인덱스 튜플에서 조건을 먼저 걸러 통과한 것만 행을 읽습니다.
Using where도 “행을 읽어온 뒤”가 아닙니다. 서버 계층에서 한 번 더 평가했다는 뜻이고, 그 대상이 행인지 인덱스 튜플인지는 이 딱지만으로 모릅니다. 11장에서 나쁜 패턴들이 Using where; Using index였던 게 그 경우예요. COUNT(*)라 인덱스 튜플만 보고 걸렀습니다.
핵심 — 요청 229배, 교차점은 26~34%에서 75%로
rt_random(50만 행)에 인덱스를 두 개 두고 같은 쿼리를 강제로 각각 태웠습니다. 둘 다 txno로 시작하고 하나만 body를 더 달고 있어요.
ALTER TABLE rt_random ADD KEY k_wide (txno, body);   -- 커버링용. body 를 더 단다

SELECT COUNT(body) FROM rt_random FORCE INDEX (idx_txno) WHERE txno BETWEEN ? AND ?;  -- 왕복
SELECT COUNT(body) FROM rt_random FORCE INDEX (k_wide) WHERE txno BETWEEN ? AND ?; -- 커버링| 실제 행 | 비율 | 경로 | Extra | 페이지 요청 | 소요 ms | 풀스캔 ms |
|---|---|---|---|---|---|---|
| 16,384 | 3.3% | 왕복 | Using index condition | 49,524 | 29 | 177 |
| 16,384 | 3.3% | 커버링 | Using where; Using index | 216 | 8.86 | 177 |
| 65,536 | 13.1% | 왕복 | Using index condition | 198,156 | 86.1 | 174 |
| 65,536 | 13.1% | 커버링 | Using where; Using index | 816 | 36.4 | 174 |
| 131,072 | 26.2% | 왕복 | Using index condition | 396,344 | 170 | 186 |
| 131,072 | 26.2% | 커버링 | Using where; Using index | 1,616 | 65.3 | 186 |
| 168,947 | 33.8% | 왕복 | Using index condition | 510,882 | 215 | 188 |
| 168,947 | 33.8% | 커버링 | Using where; Using index | 2,076 | 84.9 | 188 |
✅ 실측 (MySQL 8.0.46 / Docker / Apple M1 / macOS, 2026-08. rt_random 50만 행, 버퍼풀 1GB로 전부 상주. 적응형 해시 인덱스는 기본값 ON입니다. 7장이 왕복을 4.00에서 3.02로 깎는다고 잰 그 조건이에요. 시간은 5회 중앙값, 요청은 1회분. 재현: ./ch16/covering.sh. 전체 소스: docs/book/code/db-index/ch16/covering.sh)
229배에서 246배입니다. 같은 행을 같은 테이블에서 같은 선두 컬럼으로 찾는데요.
행당 3.02는 7장의 그 숫자입니다
요청을 행 수로 나눠보면 이유가 한눈에 보입니다.
| 실제 행 | 왕복: 행당 요청 | 커버링: 행당 요청 |
|---|---|---|
| 16,384 | 3.023 | 0.0132 |
| 65,536 | 3.024 | 0.0125 |
| 168,947 | 3.024 | 0.0123 |
✅ 실측 (같은 환경)
행 하나당 정확히 3.02번입니다. 구간이 열 배로 커져도 안 변해요.
7장에서 잰 값이 그겁니다. 세컨더리 인덱스에서 PK를 들고 클러스터드로 내려가는 왕복이 요청 3.02회라고요. 적응형 해시 인덱스가 4.00을 3.02로 줄여준 그 값이에요.
정의는 조금 다릅니다. 7장은 rt_ordered에서 왕복 몫만 떼어(비커버링 − 커버링) 3.02를 얻었고, 이 장은 rt_random에서 총 요청을 행으로 나눠 3.02를 얻었습니다. 이 장 값에서 7장 정의로 왕복 몫만 빼면 (49,524 − 216) ÷ 16,384 = 3.01이고요.
정의도 테이블도 다른데 3.01과 3.02가 나왔습니다. 커버링 몫이 0.013으로 워낙 작아서 총 요청과 왕복 몫이 소수 둘째 자리에서 만난 거예요.
커버링 쪽은 행당 0.012입니다. 행마다 뭘 하는 게 아니라 페이지를 순서대로 훑고 지나가니까요. 왕복은 행 수에 비례하고 커버링은 페이지 수에 비례합니다. 그게 229배의 정체예요.
12장 질문 1의 답은 교차점이 두 배 넘게 밀린다는 것입니다
12장에서 옵티마이저는 13.1%에 인덱스를 버렸고, 실제로 풀스캔이 이기기 시작한 건 26~34%였습니다.
커버링으로 같은 걸 재봤습니다.
| 실제 행 | 비율 | 커버링 ms | 풀스캔 ms | 승자 |
|---|---|---|---|---|
| 168,947 | 33.8% | 89.1 | 188 | 커버링 |
| 303,414 | 60.7% | 159 | 194 | 커버링 |
| 500,000 | 100.0% | 263 | 201 | 풀스캔 |
✅ 실측 (같은 환경. 5회 중앙값)
(33.8%가 앞 표의 84.9와 다른 건 별도 실행이라서입니다. 같은 조건 재실행이 84.9~89.1로 흔들린다는 뜻이고, 교차점을 소수점까지 단정하지 않는 이유이기도 해요.)
60.7%에서도 커버링이 이깁니다. 100%에서야 집니다. 두 점을 이어 보면 교차점이 약 75%예요.
| 경로 | 실제 교차점 |
|---|---|
| 왕복 있음 (12장) | 26~34% |
| 커버링 | 약 75% |
왕복 하나를 없앴더니 교차점이 두 배 넘게 밀렸습니다. 12장에서 “몇 % 넘으면 인덱스가 손해”라는 고정 숫자가 없다고 했는데, 그 이유 중 제일 큰 게 이겁니다.
📄 75%는 60.7%와 100%를 이어 얻은 값입니다. 다만 가정에만 기댄 값은 아니에요. 앞뒤 두 표의 커버링 여섯 점이 행 비율 1%p당 2.63ms짜리 직선 위에 거의 그대로 올라갑니다(13.1%·26.2%·33.8% 예측이 실측과 5% 안에서 맞습니다). 풀스캔도 1%p당 0.25ms로 직선이고요. 두 직선을 세우면 73.9%가 나옵니다.
대가로 인덱스가 3.8배로 부풉니다
여기까지만 보면 안 쓸 이유가 없습니다. 대가를 재봅시다. 13장에서 잘라냈던 폭 축이에요.
| 인덱스 | 컬럼 폭 | 소요 증가분 | 분할 증가분 | 리프(쓴 양) | 할당(차지한 양) |
|---|---|---|---|---|---|
좁은 (rnd1) | 20B | 1,512 ms | 1,617 | 1,614 | 1,894 |
커버링 (rnd1, body) | 120B | 2,757 ms | 6,222 | 6,156 | 7,168 |
| 배율 | 6배 | 1.82배 | 3.85배 | 3.81배 | 3.78배 |
✅ 실측 (같은 환경. 50만 행, 3회 중앙값. 증가분은 인덱스 없는 조건(1,577ms / 8,342회)을 뺀 값입니다. 재현: ./ch16/widthcost.sh)
표의 테이블은 앞의 읽기 실험과 다릅니다. 13장에서 쓴 w_src예요. 비교가 성립하는 건 엔트리 폭이 같기 때문입니다. 좁은 쪽이 양쪽 다 34바이트, 넓은 쪽이 양쪽 다 135바이트니까요. (13장 조건을 다시 돌린 값이라 시간만 조금 다릅니다. 분할 1,617·리프 1,614는 13장과 한 자리도 안 달라요.)
키를 6배 넓혔더니 자리는 3.8배, 삽입 시간은 1.8배가 됐습니다.
폭이 6배인데 자리가 3.8배인 건 엔트리에 폭과 무관한 몫이 있어서예요. 14장에서 뜯어본 그대로 세보면 이렇습니다.
좁은 엔트리 : 21(rnd1 = 길이 1 + 20) + 8(PK) + 5(헤더)              =  34 B
넓은 엔트리 : 21 + 101(body = 길이 1 + 100) + 8 + 5                 = 135 B
                                                    135 ÷ 34 = 3.97배
실측 리프 배율                                                  3.81배
컬럼 폭 6배가 엔트리에서 3.97배로 깎이고, 실제 자리에서 3.81배로 한 번 더 깎입니다. 뒤쪽 차이는 채움률이고요(좁은 65.8%, 넓은 66.9%. 폭이 6배 달라도 난수 삽입이 남기는 공기는 같은 자리입니다).
그러니 거래는 이렇습니다.
읽기 페이지 요청 229~246배를 사고, 쓰기 자리 3.8배와 삽입 시간 1.8배를 팝니다.
삽입 한 건이 무는 값이 1.8배이고 조회 한 건이 아끼는 요청이 230배 안팎이니, 쓰기 대 읽기가 100:1이어도 남습니다. 로그 테이블처럼 쓰기가 핫패스인 곳이라면 계산이 달라집니다.
방금 만든 인덱스와 오래 굴린 인덱스는 다릅니다
rt_random에는 인덱스가 둘 있습니다. idx_txno는 테이블을 만들 때부터 있어서 INSERT로 유지됐고, k_wide는 데이터를 다 넣은 뒤 ALTER로 만들었어요.
같은 테이블, 같은 데이터, 같은 순간입니다. 채움률만 봅시다.
| 인덱스 | 엔트리 | 100% 채웠을 때 | 실측 리프 | 채움률 |
|---|---|---|---|---|
idx_txno (txno) — INSERT로 유지 | 34 B | 1,038장 | 1,654장 | 63% |
k_wide (txno, body) — ALTER로 생성 | 135 B | 4,120장 | 4,202장 | 98% |
✅ 실측 (같은 환경. 엔트리는 14장에서 잰 방식으로 계산했습니다)
나중에 만들면 InnoDB가 값을 정렬해서 차곡차곡 채웁니다. 넣으면서 유지하면 난수 키가 트리 여기저기를 쪼개고 다녀서 63%에 그치고요. 14장에서 잰 65.8%가 그 값입니다.
쓰기 실험에서도 같은 게 나옵니다. 거기 커버링 인덱스는 인덱스를 걸어둔 채 INSERT한 거라 리프가 6,156장이었어요. ALTER로 만든 4,202장과 폭이 같은데(둘 다 엔트리 135바이트) 1.46배 헐겁습니다. 채움률로는 67% 대 98%고요.
그러니 방금 만든 인덱스와 1년 쓴 인덱스는 다른 물건입니다. 이 장의 읽기 표가 좋게 나온 데는 ALTER로 갓 만든 인덱스라는 사정도 섞여 있어요.
그럼 결론이 흔들릴까요. 두 갈래로 따져봤습니다.
먼저 페이지 요청입니다. k_wide가 1.46배 헐거워지면 216회가 316회가 되고, 229배는 157배가 됩니다. 여전히 세 자리예요. 왕복 경로 쪽은 거의 안 변합니다. 그 49,524회 중 99.6%가 왕복 몫이라((49,524−216) ÷ 49,524) 인덱스가 헐거워지는 건 왕복 쪽 숫자를 건드리지 않아요. 비대칭이 커버링 편만 들어주는 셈이라, 보정하면 그만큼 깎입니다.
그리고 시간입니다. 요청이 1.46배면 89.1ms도 130ms가 되고 교차점 75%가 무너지는 것 아닐까요. 14장이 이미 답했습니다. 거기서 페이지 요청이 2.03배(1,425 대 2,891)인 두 인덱스의 시간이 90.6ms 대 95.0ms, 1.05배였어요. 전부 메모리에 있으면 요청 배율이 시간 배율로 안 넘어옵니다. 그러니 1.46배 요청은 시간을 2~3% 늘리는 정도고, 교차점은 75%에서 72%쯤으로 움직입니다.
결론은 안 뒤집힙니다. 다만 배율은 깎아서 읽으세요.
그럼 컬럼을 다 넣으면 되지 않나요
면접 질문 셋째가 이겁니다. 답은 위 거래표에 있어요.
| 컬럼을 더 넣으면 | 무슨 일이 |
|---|---|
| 인덱스가 넓어진다 | 자리가 늘고 삽입이 느려진다(이 장: 6배 폭 → 3.8배 자리) |
| 페이지당 엔트리가 준다 | 같은 건수를 훑는 데 페이지를 더 요청한다 |
| 트리 높이는 이 규모에선 안 변했다 | 좁은 1,614장·넓은 6,156장 둘 다 높이 3이다. 높아지는 건 리프가 만 단위로 갈 때고(2장) |
| 결국 테이블을 복제한다 | 모든 컬럼을 넣으면 클러스터드 인덱스를 한 벌 더 만든 셈이다 |
마지막 줄을 보세요. 모든 컬럼을 담은 인덱스는 테이블의 사본입니다(6장. 테이블이 곧 클러스터드 인덱스니까요).
그래서 커버링은 “다 넣기”가 아니라 한두 개 쿼리를 정해놓고 딱 그만큼만 넣는 기술입니다. 폭이 값을 청구하니까요.
MySQL 8.0에는 CREATE INDEX ... (a) INCLUDE (b) 같은 문법이 없습니다(쳐보면 ERROR 1064예요. PostgreSQL과 SQL Server의 문법입니다). 커버링을 만들려면 컬럼을 인덱스 키에 그냥 붙여야 하고, 📄 그러면 정렬·유니크 판정에도 그 컬럼이 참여합니다.
정리
- 커버링 인덱스는 별도의 종류가 아니라 “이 쿼리에 필요한 컬럼이 인덱스에 다 들어 있는 상태”입니다. 같은 인덱스가 쿼리에 따라 커버링이기도 아니기도 해요.
Extra가Using index면 커버링이고,Using index condition이면 행을 읽으러 내려간 겁니다.- 실측: 페이지 요청이 49,524 → 216입니다. 구간을 넓혀도 229~246배로 유지돼요.
- 이유는 행당 요청 3.02 대 0.012입니다. 왕복은 행 수에 비례하고 커버링은 페이지 수에 비례해요. 3.02는 7장에서 다른 방식으로 잰 왕복 비용과 같은 값입니다.
- 12장 질문 1의 답: 교차점이 26~34%에서 약 75%로 밀립니다. 왕복 하나를 없앤 결과예요.
- 대가는 폭입니다. 키를 6배 넓히면 자리 3.8배, 삽입 시간 1.8배입니다. 읽기 요청 230배 안팎을 사고 쓰기 자리 3.8배를 파는 거래죠.
- 방금 만든 인덱스와 오래 굴린 인덱스는 다른 물건입니다. 같은
rt_random안에서INSERT로 유지된idx_txno는 채움 63%,ALTER로 만든k_wide는 98%예요. 이 장 읽기 표가 좋게 나온 데 그 사정이 섞여 있습니다. 보정하면 229배가 157배쯤 되고, 시간 교차점은 75%에서 72%쯤으로 움직입니다. - 모든 컬럼을 담은 인덱스는 테이블의 사본입니다. 커버링은 “다 넣기”가 아니라 쿼리를 정해놓고 딱 그만큼만 넣는 기술입니다.
생각해볼 질문
- 이 장의 커버링 인덱스는
(txno, body)입니다. 순서를(body, txno)로 바꾸면 이 쿼리에 여전히 커버링일까요? 그리고 여전히 쓸모 있을까요? ALTER로 만든 인덱스가 98%로 빽빽했습니다. 그럼 오래 굴려 헐거워진 인덱스를 다시 빽빽하게 만들려면 어떻게 해야 할까요? 그리고 운영 중에 그걸 하면 무슨 일이 생길까요? (5부)- 왕복은 행당 3.02회였습니다. 클러스터드 인덱스 높이가 3이니 거기 하나가 더 붙은 값이에요(7장이 그 하나를 못 밝혔습니다). 그럼 커버링의 0.012는 어디서 나온 숫자일까요? 리프 한 장에 엔트리가 몇 개 들어가는지로 검산해보세요.
4부가 끝났습니다. 인덱스가 무엇을 청구하는지 네 장에 걸쳐 봤어요. 키 모양이 정하는 계수(13장), 분할이 남기는 빈 공간(14장), 그걸 받아내는 완충(15장), 그리고 왕복을 없애는 값(16장).
관통하는 건 하나입니다. 인덱스는 읽기를 사는 대신 쓰기를 팝니다. 무엇을 얼마에 사고파는지가 장마다 달랐을 뿐이에요.
그런데 4부의 모든 측정에는 조용한 전제가 하나 있었습니다. 인덱스를 만들 수 있다는 것이요. 빈 테이블에 걸고 데이터를 넣거나, 놀고 있는 테이블에 ALTER를 치거나요.
운영 중인 테이블은 놀고 있지 않습니다. 방금 본 그 ALTER TABLE ... ADD KEY 한 줄을, 초당 수백 건이 들어오는 4.6GB 테이블에 치면 무슨 일이 생길까요.