14장. 전역 풀 오염 — commonPool에 블로킹을 던지면
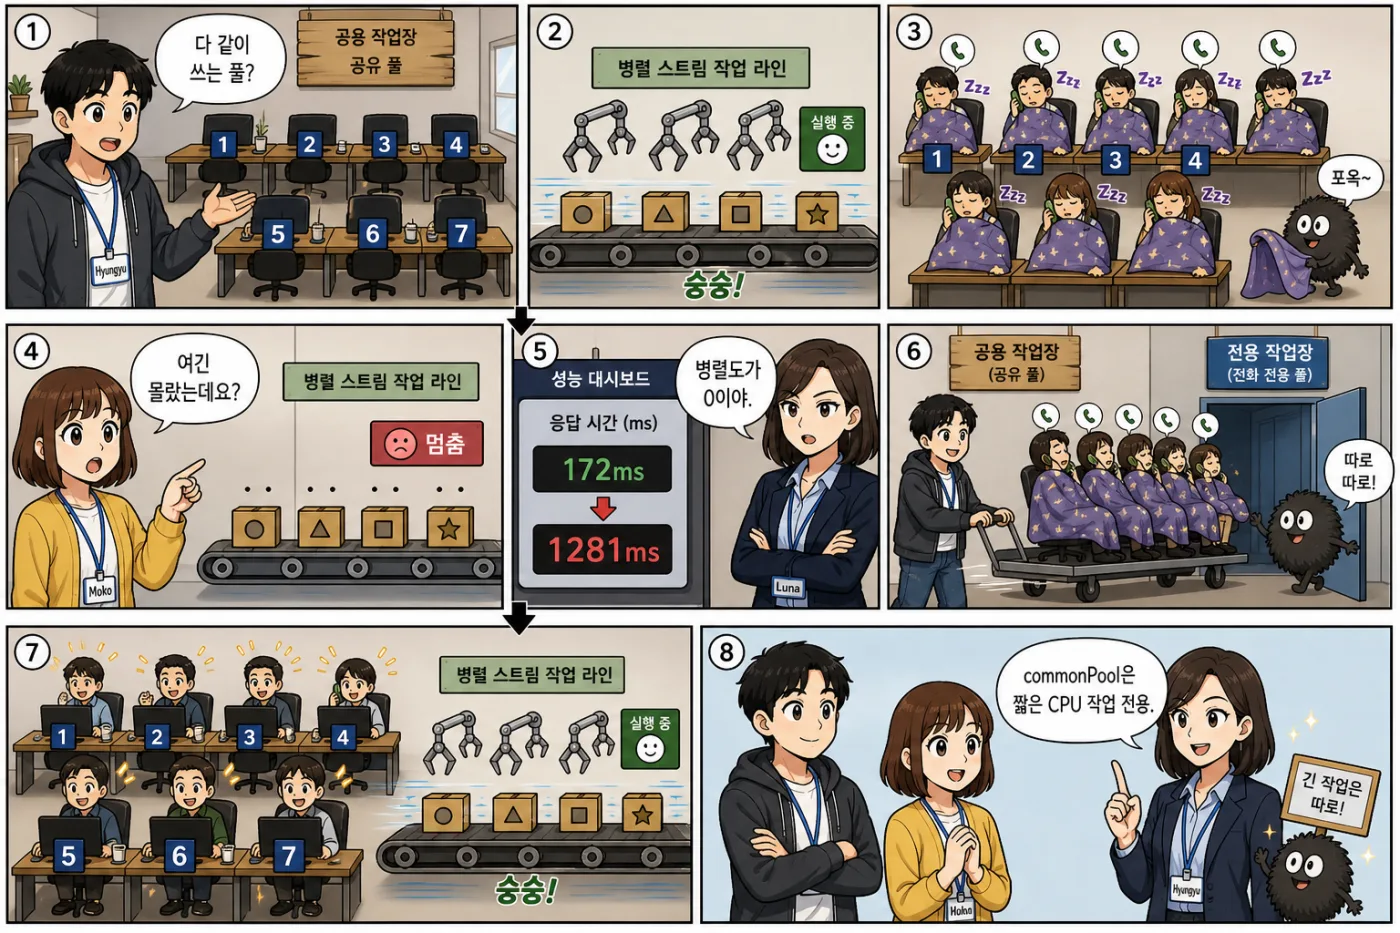
만화로 보는 요약 — 먼저 읽어보세요
병렬 스트림이 172ms에서 1,281ms가 됐습니다. 그 스트림은 블로킹 작업이 있는 줄도 몰랐어요.
면접 실전 질문: ①
supplyAsync에 Executor를 안 넘기면 어디서 도나요? ②commonPool에 블로킹 작업을 던지면 왜 위험한가요? ③ 병렬 스트림과CompletableFuture가 왜 서로 영향을 주나요?
배경 — 아무도 자기가 공유하는 줄 모른다
13장 마지막 질문입니다.
“
CompletableFuture.supplyAsync(task, pool)에서pool을 지정하지 않으면 어디서 돌까요?”
11장에서 실측으로 확인했죠. ForkJoinPool.commonPool입니다. 그리고 그 풀의 병렬도는 이 기계에서 7이었어요. 가용 코어 − 1.
이름에 답이 있습니다. common, 공용입니다. 얼마나 공용이냐면, JVM 안에서 commonPool을 쓰는 곳이 한둘이 아니에요.
| 이 코드가 | 쓰는 풀 |
|---|---|
CompletableFuture의 인자 없는 모든 *Async (supplyAsync·runAsync·thenApplyAsync·thenComposeAsync…) | commonPool |
모든 병렬 스트림 (parallelStream()·stream().parallel()) | commonPool |
Arrays.parallelSort / parallelPrefix / parallelSetAll | commonPool |
인자 없는 *Async를 쓰는 서드파티 라이브러리 | commonPool |
목록의 어느 항목도 나머지를 알지 못합니다. 병렬 스트림을 쓰는 코드는 저 아래 어딘가에서 누가 supplyAsync를 부르는지 모르고, 그 반대도 마찬가지예요.
그런데 둘은 같은 워커 7개를 나눠 씁니다.
그 7개가 전부 막히면요? 저 표의 나머지 항목들이 함께 멈춥니다.
스토리 — ForkJoinPool은 자는 걸 전제하지 않는다
왜 하필 7일까요? 왜 코어 수보다 하나 적을까요?
ForkJoinPool은 원래 CPU 작업을 잘게 쪼개 나눠 돌리려고 만들어진 물건입니다. 큰 배열 정렬, 병렬 스트림 같은 것들이요. 그런 작업의 전제는 이렇습니다.
워커는 항상 실행 가능한 상태다. CPU만 있으면 계속 일한다.
이 전제 아래서는 워커를 코어 수만큼만 두는 게 최적입니다. 더 두면 컨텍스트 스위치만 늘어나니까요(9장에서 본 CPU 바운드 처방 그대로입니다). 하나를 뺀 건 호출한 스레드도 일을 돕기 때문이고요.
블로킹 작업은 이 전제를 정면으로 위반합니다.
100ms짜리 HTTP 호출을 commonPool에 던지면, 워커 하나가 100ms 동안 5장에서 본 그 park 상태로 들어갑니다. CPU는 안 쓰지만 워커 슬롯은 점유한 채로요. 7개 중 하나가 사라진 겁니다.
일곱 개를 던지면요?
핵심 — 약 7배, 그리고 1,280ms의 의미
세 가지 조건을 나란히 재봤습니다.
측정 환경은 Apple M1(8코어) / 램 16GB / macOS 26.5 / JDK 25입니다. 전체 소스는 docs/book/code/async/Ch14CommonPool.java에 있습니다.
측정 대상은 commonPool을 쓰는 평범한 코드 하나입니다. 20ms짜리 CPU 작업 64개를 병렬 스트림으로 돌려요. 블로킹 작업과는 아무 관계가 없는 코드입니다.
IntStream.range(0, 64).parallel()
         .mapToLong(i -> { burn(20); return i; })    // 20ms CPU 작업 × 64
         .sum();
그리고 이 스트림을 돌리기 직전에, 조건을 다르게 만들었습니다.
- baseline — 아무것도 안 던짐
- polluted —
commonPool에 2초짜리 블로킹 작업 7개를 던짐(병렬도만큼) - dedicated — 같은 블로킹 작업 7개를 전용 풀에 던짐
결과
| 조건 | 병렬 스트림 소요 | 기준 대비 |
|---|---|---|
| baseline | 172 ms | 1× |
commonPool 오염 | 1,281 ms | 약 7× |
| 전용 풀로 분리 | 162 ms | 1.0× |
✅ 실측 (같은 환경, 2026-08. 각 조건 5회, 중앙값. 세 조건 모두 같은 병렬 스트림(20ms × 64)을 잽니다. baseline은 블로킹 없음, polluted·dedicated는 동일한 2초짜리 블로킹 7개를 각각 commonPool과 전용 풀에 던졌습니다.)
회차 편차가 재미있습니다. baseline은 168200ms로 18% 흔들리는데 polluted는 1,2811,283ms, 편차 2ms입니다. 오염된 쪽이 더 안정적이에요. 순차 실행이라 그렇습니다. 그리고 dedicated(162ms)가 baseline(172ms)보다 빠른 것도 노이즈입니다. 5회 범위가 겹쳐요(168200 vs 165180). 그게 요점입니다. 전용 풀에 던진 블로킹은 병렬 스트림에 측정 가능한 영향이 없습니다.
덧붙이면 dedicated 쪽이 오히려 불리한 조건입니다. 플랫폼 스레드를 7개 더 만들어 그 7개가 자고 있는데도 baseline과 구분이 안 됐거든요.
1,281이라는 숫자를 보세요
이 값이 우연이 아닙니다. 계산해봅시다.
작업 총량 = 20ms × 64개 = 1,280ms.
측정값이 1,281ms예요. 차이가 1ms입니다.
병렬 스트림이 순차로 떨어졌습니다. 속도 향상이 1배예요. 워커 7개가 전부 블로킹에 잡혀 있으니, 일을 한 건 parallel()을 호출한 스레드 하나뿐이었습니다. 8개가 나눠 들 일을 혼자 든 겁니다.
청크마다 어느 스레드가 처리했는지 찍어보면 {main=64}입니다. 64개 전부를 호출 스레드가 처리했어요.
블로킹은 2초고 스트림은 1.28초입니다. 스트림이 끝날 때까지 워커는 한 명도 안 깨어납니다. 왜 풀이 워커를 더 안 띄우냐고요? 잠시 뒤에 답합니다.
.parallel()을 붙였는데 순차로 돌았습니다. 코드는 그대로인데요.
세 번째 줄이 처방입니다
같은 블로킹 작업 7개를 전용 풀에 던졌더니 162ms로, baseline과 차이가 없습니다.
코드 차이는 인자 하나예요.
CompletableFuture.supplyAsync(() -> blockingCall());          // ← commonPool. 남의 병렬 스트림이 7배 느려짐
CompletableFuture.supplyAsync(() -> blockingCall(), myPool);  // ← 전용 풀. 아무도 안 다침
다만 전용 풀은 격리지 해결이 아닙니다. 100ms 블로킹은 어느 풀에서 돌아도 100ms예요. 옮긴 건 누가 그 100ms를 무느냐뿐이고, 그 전용 풀은 9장의 리틀의 법칙과 8장의 세금을 그대로 물려받습니다. 15장에서 그 값을 잽니다.
두 번째 인자를 안 쓰면 JVM 전역 자원을 쓰는 겁니다. 라이브러리를 만든다면 특히요. 여러분 라이브러리를 쓰는 애플리케이션의 병렬 스트림까지 함께 멈추게 되니까요.
왜 이 버그는 잡기 어려운가
이 문제가 지독한 이유가 셋 있습니다.
첫째, 증상과 원인이 코드상 아무 관계가 없습니다. 느려진 건 병렬 스트림인데, 원인은 저 멀리 다른 파일의 supplyAsync예요. 스택 트레이스에도 안 나옵니다. 프로파일러를 켜도 “병렬 스트림이 느리네”까지만 보입니다.
잡는 법은 사실 하나뿐입니다. 느릴 때 스레드 덤프를 뜨세요. jstack <pid> | grep commonPool-worker. 워커들이 전부 TIMED_WAITING이나 WAITING이고 스택 맨 위에 sleepNanos0·소켓 read·JDBC 드라이버가 찍혀 있으면 확정입니다. commonPool 워커는 원래 자면 안 되는 스레드예요. 자고 있으면 그 자체가 범행 현장입니다.
둘째, 부하가 낮을 때는 안 터집니다. 블로킹 작업이 동시에 12개면 워커 7개 중 56개가 남아 있어요. 조금 느려질 뿐 눈에 안 띕니다. 동시 블로킹이 7개에 이르는 순간 스트림은 호출 스레드 혼자 도는 상태가 됩니다. 부하가 임계점을 넘을 때 절벽처럼 무너져요.
셋째, 컨테이너에서 훨씬 빨리 옵니다. 11장에서 봤듯 commonPool 병렬도는 가용 코어 − 1이고 최솟값이 1입니다. cpu: 2 컨테이너면 워커가 하나예요. 블로킹 작업 딱 하나로 JVM 전체의 commonPool이 멈춥니다.
임계점이 코어 수를 따라 내려갑니다. 8코어 노트북에서는 동시 블로킹이 7개는 돼야 하지만,
cpu: 2컨테이너에서는 1개면 충분해요. 개발 환경의 평소 부하로는 절대 안 닿는 임계점이, 운영에서는 요청 하나로 닿습니다. 13장의InheritableThreadLocal과 같은 종류의 함정이에요.
ForkJoinPool에는 탈출구가 하나 있다
공정하게 적어둡시다. ForkJoinPool도 블로킹을 완전히 모르지는 않습니다. ManagedBlocker라는 장치가 있어요.
ForkJoinPool.managedBlock(blocker); // "나 잠깐 잘 건데, 보상 스레드를 하나 띄워줘"워커가 블로킹에 들어가기 전에 이걸 부르면, 풀이 보상 스레드(compensation thread)를 임시로 하나 더 만들어 병렬도를 유지합니다. 10장에서 본 CompletableFuture.join()이 내부적으로 이걸 씁니다. 반면 같은 10장의 FutureTask.get()은 안 씁니다. 그때 본 스택 기억하시죠? LockSupport.park가 바로 찍혔어요. 보상 없이 워커가 그냥 사라집니다.
그리고 보상은 commonPool 워커가 부를 때만 일어납니다. 여러분의 톰캣 스레드가 부르는 join()은 그냥 막혀요. 보상 스레드에도 상한이 있고요(기본 256개).
문제는 여러분의 Thread.sleep()이나 JDBC 호출은 이걸 안 부른다는 겁니다. 그냥 자버려요. 풀은 워커가 자고 있는 줄도 모릅니다.
그리고 보상 스레드도 공짜가 아니에요. 많이 만들면 8장에서 본 그 세금을 내게 됩니다.
정리하면 규칙은 하나입니다
commonPool은 짧은 CPU 작업 전용입니다. I/O·sleep·락 대기가 섞이는 순간, Executor를 명시적으로 넘기세요.
그리고 이 규칙은 12장의 규칙과 사실 같은 말입니다. “이벤트 루프를 막지 마라”와 “commonPool을 막지 마라”는 같은 문장이에요. 둘 다 코어 수만큼만 있는, 자면 안 되는 스레드를 공유 자원으로 쓰고 있거든요.
다음 장에서 그 둘이 만납니다.
정리
commonPool은 JVM 전역 공용입니다.supplyAsync(Executor 없이),thenApplyAsync(Executor 없이), 병렬 스트림,parallelSort가 전부 같은 워커 7개를 나눠 씁니다. 서로를 모른 채로요.ForkJoinPool은 워커가 자지 않는다는 전제로 설계됐습니다. 그래서 병렬도가 코어 수 언저리예요. 블로킹은 이 전제를 위반합니다.- 실측: 블로킹 7개로
commonPool을 채우자 무관한 병렬 스트림이 172ms → 1,281ms(약 7배)가 됐습니다. 1,281ms는 작업 총량(20ms × 64 = 1,280ms)과 같아요. 속도 향상이 1배, 호출 스레드 혼자 순차로 돌았습니다(청크 64개 전부main). - 같은 블로킹을 전용 풀에 던지면 162ms, 영향이 없습니다. 차이는 인자 하나예요.
- 잡기 어려운 버그입니다. 증상과 원인이 코드상 무관하고, 부하가 임계점을 넘을 때 절벽처럼 무너집니다. 임계점은 코어 수를 따라 내려가요. 8코어에선 동시 블로킹 7개가 필요하지만
cpu: 2컨테이너에선 1개면 됩니다. ManagedBlocker라는 탈출구가 있지만 여러분의sleep이나 JDBC는 그걸 안 부릅니다.CompletableFuture.join()은 쓰고FutureTask.get()은 안 씁니다.- 진단은 스레드 덤프 한 방입니다.
commonPool-worker가 자고 있으면 그게 범행 현장이에요.
생각해볼 질문
cpu: 1컨테이너에서commonPool병렬도는 몇일까요? 그 환경에서supplyAsync(() -> jdbcCall())을 한 번 부르면 무슨 일이 생길까요?commonPool을 아예 안 쓰게 만들 방법이 있을까요? 라이브러리가 내부에서 쓰고 있다면요?- 이 장의 규칙(“자면 안 되는 공유 스레드를 막지 마라”)은 12장의 이벤트 루프 규칙과 같은 말입니다. 그럼 WebFlux 애플리케이션에서
JdbcTemplate을 부르면, 이 장의 7배에 해당하는 값은 얼마일까요?
3번이 다음 장입니다. 12장에서 루프 하나를 100ms 막아 p50을 83ms 밀어봤죠. 이번엔 루프를 8개로 늘리고 블로킹을 1%로 희석해서, 실제 서비스가 만나는 비율로 그 값을 재고 어떻게 빠져나오는지까지 봅니다.